

¿Qué pasó ayer? En un minuto:
Figure presenta Helix 2.5, que según la compañía logra por primera vez autonomía de cuerpo completo en hogares no vistos y eleva el éxito en tareas domésticas del 9% al 56%.
OpenAI lanza en EE.UU. Astra for Law, una configuración de GPT-6 Astra para despachos de abogados con un índice de búsqueda jurídica propio, que compite con los asociados junior y con los proveedores de tecnología legal establecidos.
Anthropic lleva Projects a Claude Code, donde un orquestador reparte el trabajo en hilos paralelos con memoria común que siguen ejecutándose en la nube, disponible por lista de espera para usuarios de los planes Pro y Max.
Zai explica cómo GLM-5.3 ayudó a construir la infraestructura de inferencia de su variante Flash sobre chips fabricados en China, triplicando el rendimiento y reduciendo la dependencia de hardware extranjero.
Anthropic publica un informe que cuantifica por primera vez qué parte de su I+D ejecuta su propia IA, con Claude liderando ya el 26% de las tareas frente al 1% de hace seis meses.
Un desarrollador usa GPT-6 Astra para descifrar en unas diez horas de trabajo autónomo un mensaje Enigma de 1941 que llevaba más de ocho décadas sin resolverse, un ejemplo de tarea de horizonte largo con resultado verificable.
Gracias por leer 1 Minuto de IA. Si te ha gustado esta edición, no te olvides de dar al ♡ y de compartirla por redes sociales o por email con otras personas a las que creas que les pueda interesar.
Y si tienes más de un minuto…
1. Figure valida Helix 2.5 en 30 casas alquiladas
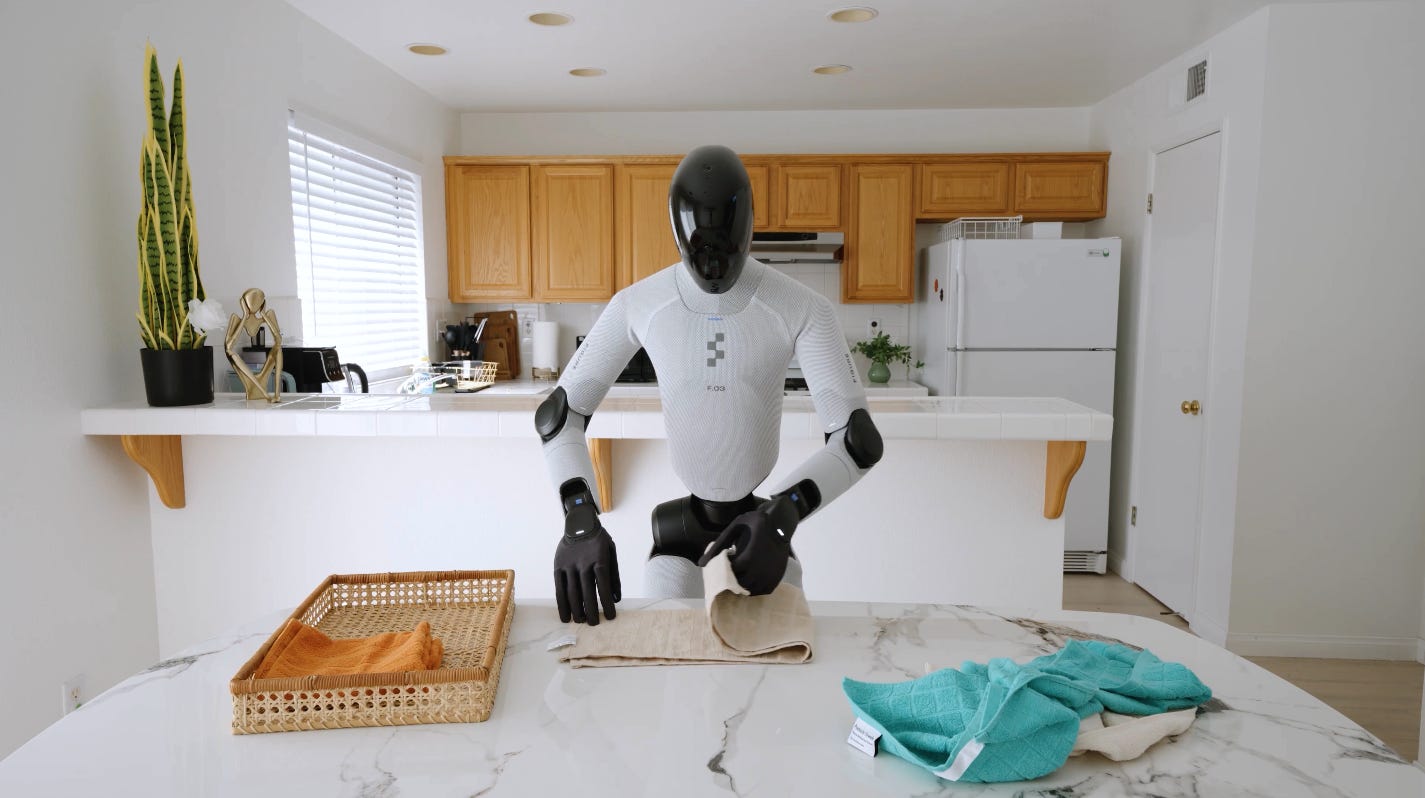
Figure ha presentado Helix 2.5, la red neuronal para control robótico más avanzada que ha construido la compañía, y la ha probado alquilando 30 viviendas del área de la Bahía de San Francisco. Los robots entraron en esas casas sin recogida de datos previa, sin ajuste fino y sin adaptación a los objetos manipulados. El modelo se preentrenó sobre Index, el conjunto de datos de comportamiento humano a escala global de la propia empresa, y de ese único modelo fundacional salieron tres comportamientos de horizonte largo: ordenar salones, doblar toallas y hacer camas.
La compañía sostiene que es la primera demostración de autonomía de cuerpo completo en modo zero-shot en hogares reales no vistos. El punto de comparación es Helix 02, que ya coordinaba el cuerpo completo en tareas largas, desde vaciar un lavavajillas hasta 200 horas seguidas de operación logística, pero aprendía siempre con datos tomados en el mismo sitio donde después trabajaba el robot. Ahí está el cambio: pasar de sistemas que memorizan un entorno a uno que traslada su comprensión física a otro distinto.
La cifra que aporta Figure sobre la mejora es una tasa de éxito en tareas domésticas que sube del 9% al 56% con Helix 2.5. La empresa ha publicado además un vídeo con cuatro horas continuas de trabajo autónomo grabado en esas 30 viviendas de alquiler, junto a una nota técnica detallada.
El planteamiento con el que 𝕏 @Figure_robot (Figure) enmarca el lanzamiento es deliberadamente exigente: si un humanoide puede entrar en una casa que nunca ha visto y empezar a trabajar de inmediato, con todo el cuerpo y sin supervisión.
Para 𝕏 @rohanpaul_ai (Rohan Paul) el salto de más de seis veces en éxito sobre hogares no vistos es la señal de que el futuro robótico doméstico se acerca de verdad, no solo en demostraciones de laboratorio.
La lectura que más le interesa a 𝕏 @kimmonismus (Chubby) no es la demostración en sí, sino que las leyes de escalado conocidas en los modelos de lenguaje parecen funcionar igual en robótica con datos de vídeo: más datos de entrenamiento, mejor desempeño físico.
La reacción de 𝕏 @NVIDIAAI (Nvidia Ai) al anuncio se limitó a un gesto de atención, pero viniendo del principal proveedor de cómputo del sector funciona como aval implícito de la línea de trabajo.
En el mismo hilo, 𝕏 @testingcatalog (Ai News | Testingcatalog) amplificó el interés antes del lanzamiento, una señal de que el anuncio se venía anticipando en los círculos que siguen de cerca los humanoides.
Más información:
📎 Helix 2.5: Zero-Shot 30-Home Generalization
2. OpenAI lanza Astra for Law para despachos
OpenAI ha presentado Astra for Law, una configuración vertical de su modelo GPT-6 Astra orientada al trabajo jurídico en Estados Unidos. El paquete combina el modelo con instrucciones específicas para análisis y redacción legal, ajustes para tareas largas y exhaustivas, y un nuevo Legal Search Index que rastrea jurisprudencia, leyes, reglamentos, normas procesales y decisiones administrativas, con incorporación diaria de fuentes. La privacidad de datos se presenta como característica central del producto, no como añadido.
Alrededor del modelo hay ya un ecosistema de extensiones dentro de ChatGPT: 26 plugins desarrollados por socios, entre ellos Thomson Reuters, Harvey, Legora e iManage, y 47 plugins creados por la comunidad de abogados e ingenieros legales. Varios despachos han trabajado directamente con ingenieros de OpenAI para construir herramientas propias, como un analizador de contratos de Sullivan & Cromwell, un sistema de due diligence para fusiones y adquisiciones de Ropes & Gray, y una herramienta llamada GO Public para preparar salidas a bolsa de Cooley.
El encaje competitivo es incómodo para dos colectivos a la vez. Por un lado los asociados junior, cuyo trabajo de búsqueda y revisión documental es precisamente lo que automatiza el sistema. Y por otro los proveedores de tecnología legal ya establecidos que no van a poder competir con soluciones de OpenAI, algunos de los cuales aparecen ya aquí como socios de distribución. El despliegue arranca en ChatGPT para firmas seleccionadas, con acceso por API previsto más adelante.
El argumento con el que 𝕏 @OpenAI (Openai) justifica la colaboración con despachos es que las herramientas deben diseñarlas quienes conocen el trabajo, de ahí que cada firma haya construido su propio flujo en lugar de recibir un producto cerrado.
La promesa que subraya 𝕏 @gdb (Greg Brockman) es de aceleración radical del trabajo en los despachos, con la privacidad de los datos situada al mismo nivel que las capacidades del modelo.
Para 𝕏 @rohanpaul_ai (Rohan Paul) la lectura laboral es directa: los asociados junior tienen un competidor serio, sostenido por una capa de búsqueda que cubre más de 230 millones de URLs de fuentes jurídicas estadounidenses.
La reacción de 𝕏 @testingcatalog (Ai News | Testingcatalog) fue de simple constatación del movimiento, señal de que la entrada de OpenAI en verticales profesionales ya se daba por descontada entre quienes siguen sus lanzamientos.
Más información:
📎 openai.com: Astra for law
3. Anthropic lleva Projects a Claude Code
Anthropic ha anunciado Projects para Claude Code, su herramienta de programación asistida por agentes. La idea es sencilla de describir y menos trivial de ejecutar: el usuario lanza ideas sueltas en una conversación y Claude reparte el trabajo en varios hilos paralelos que comparten una memoria de proyecto común y siguen ejecutándose en la nube aunque se cierre el portátil. Boris Cherny, responsable de Claude Code en Anthropic, lo resume como carpetas con las que se puede hablar. El cambio de fondo está en la coordinación, porque ya no se trata de un agente resolviendo una tarea, sino de un orquestador que crea especialistas y mezcla modelos caros y baratos según la preferencia del usuario.
El despliegue arranca en Claude Code con lista de espera para usuarios seleccionados de los planes Pro y Max, y se ampliará después al resto de suscriptores de esos planes. Está ya disponible en escritorio y móvil; la versión para la interfaz de línea de comandos llegará más adelante, según la propia compañía. Las demostraciones en acceso anticipado dan una idea del alcance: reconstrucciones en 3D de bibliotecas históricas, un repositorio con dieciocho misterios históricos analizados con veredictos y probabilidades explícitas, y un vídeo de 7.417 fotogramas generados con Python sobre el manuscrito Voynich.
El seguimiento de 𝕏 @testingcatalog (Ai News | Testingcatalog) al lanzamiento subraya que la función llevaba tiempo esperándose, y su petición siguiente es un Claude Hub que centralice la gestión de todo esto.
Lo que más le interesa a 𝕏 @emollick (Ethan Mollick) es que el sistema monta en la práctica una organización a medida para resolver el problema, con un agente principal que genera especialistas y los reparte.
Aun valorando bien el lanzamiento, 𝕏 @kimmonismus (Chubby) deja claro que su prioridad sigue siendo otra: un Opus 5.2 menos perezoso a la hora de ejecutar.
La respuesta de 𝕏 @bcherny (Boris Cherny) a las dudas de configuración es deliberadamente mínima, basta con pedírselo a Claude, coherente con la idea de que la orquestación se gestione hablando y no tocando ajustes.
Más información:
📎 Let Claude coordinate ongoing work with Projects
4. Zai usa GLM-5.3 para optimizar su propia infraestructura
Zai, la empresa china detrás de la familia de modelos GLM, ha publicado una entrada en su blog de investigación donde detalla cómo GLM-5.3 ha ayudado a construir y optimizar la infraestructura de inferencia que sirve a GLM-5.3-Flash, su variante ligera. El plazo es el dato que ha circulado: menos de dos semanas desde la primera ejecución correcta sobre aceleradores nacionales (chips fabricados en China) hasta estar en producción atendiendo todo el tráfico, con el rendimiento de extremo a extremo triplicado respecto a la línea base inicial.
La compañía atribuye al modelo contribuciones verificables en ese proceso: correcciones de kernels en producción y arreglos de concurrencia. Zai lo enmarca como primeros pasos hacia la automejora recursiva, es decir, modelos que ayudan a construir los sistemas que los ejecutan. Conviene indicar que lo demostrado es ingeniería de sistemas asistida por modelo, no un ciclo cerrado de mejora automática de capacidades.
El interés práctico va por dos vías. Primera, mide cuánto acelera un modelo el trabajo de optimización de infraestructura, una tarea densa y difícil de automatizar. Segunda, refuerza la posición china en cómputo propio, porque portar un modelo de producción a aceleradores domésticos en ese plazo reduce la dependencia de hardware extranjero. El despliegue descrito opera sobre más de 100.000 aceleradores.
El énfasis de 𝕏 @Zai_org (Z.Ai) está en el plazo y no en la capacidad del modelo: de la primera ejecución correcta a producción en menos de dos semanas, con el rendimiento triplicado frente al punto de partida.
Lo que destaca 𝕏 @rohanpaul_ai (Rohan Paul) es la naturaleza del trabajo aportado: correcciones de kernels y de concurrencia en producción, es decir, código que se ejecuta de verdad y no ejemplos de laboratorio.
El contraste que traza 𝕏 @kimmonismus (Chubby) es geográfico: mientras en Estados Unidos se debate moderar el ritmo, en China se empuja a fondo en la dirección contraria.
La lectura de 𝕏 @AndrewCurran_ (Andrew Curran) se queda en lo que dice literalmente el blog, señales tempranas de que GLM participa cada vez más en la construcción de la propia IA, sin extrapolar más allá.
Más información:
📎 Toward Recursive Self-Improvement: How GLM Built Its Own Inference Infrastructure
5. Anthropic publica cuánta I+D hace su propia IA
Anthropic ha publicado un informe en el que cuantifica por primera vez qué parte de su investigación y desarrollo de modelos ejecuta ya su propio sistema. El documento propone tres ejes de medición: hasta qué punto la IA construye su siguiente versión frente al trabajo humano, la capacidad de la empresa para supervisar e intervenir en las acciones que los agentes realizan sobre sus sistemas internos, y los recursos que sostienen el entrenamiento de modelos más capaces. Junto a la metodología, la compañía aporta una instantánea de sus propias cifras.
El interés va más allá de la transparencia, llega inmediatamente después de la propuesta de Dario Amodei de coordinar el ritmo entre laboratorios de frontera, y la propia Anthropic advierte de que estas métricas cambiarían si esa coordinación se materializase. Medir la automejora recursiva es también una forma de fijar el marco del debate regulatorio antes de que lo fijen otros.
Conviene mantener la cautela habitual con las autoevaluaciones, porque las definiciones de lo que cuenta como “tarea liderada por IA” todavía no están asentadas. Para reducir ese problema, Anthropic anuncia que integrará evaluadores externos independientes de varias organizaciones dentro de la casa, con acceso a procesos, sistemas y datos comparable al de sus equipos internos de evaluación de riesgos, encargados de verificar prácticas de seguridad, notificar incidentes y seguir estas métricas.
La justificación que da 𝕏 @AnthropicAI (Anthropic) para publicar estos datos es de visibilidad pública: si los sistemas se usan cada vez más para construir su siguiente versión, el ritmo interno de los laboratorios no debería ser información privada.
Lo que subraya 𝕏 @kimmonismus (Chubby) es la velocidad del salto: del 1% al 26% de tareas de I+D lideradas por Claude en unos seis meses, con el modelo participando o dirigiendo más del 90% del trabajo de desarrollo de modelos.
El matiz que recoge 𝕏 @rohanpaul_ai (Rohan Paul) importa para interpretar la cifra: ese 26% son tareas que el modelo completa de extremo a extremo desde una instrucción de alto nivel, con el humano en papel de supervisor, y con unos 30.000 agentes activos en investigación e ingeniería.
Desde dentro del proyecto, 𝕏 @jackclarkSF (Jack Clark) admite que la parte definitoria sigue siendo complicada y presenta el informe como una aportación de método para medir la autosuperación recursiva, continuación del trabajo anterior «When AI Builds Itself».
Más información:
📎 Measurements for understanding the pace of AI development inside frontier labs
6. GPT-6 Astra rompe un Enigma de 1941
El desarrollador Carter Leffen ha usado GPT-6 Astra, en su configuración de razonamiento más alta, para descifrar un mensaje cifrado con Enigma del Ejército alemán fechado el 10 de julio de 1941 y que llevaba más de ocho décadas sin resolverse. El criptograma tenía 82 letras, con una docena de posiciones dudosas, y el modelo trabajó de forma autónoma durante unas diez horas: consultó archivos históricos, buscó pistas sobre el contexto de la transmisión, escribió su propio código de ataque y probó claves hasta encontrar la válida.
El texto en claro es un mensaje operativo de campaña, una petición de ruta de marcha con la posición del emisor repetida y solicitud de respuesta inmediata por radio. En el mismo hilo se atribuye al modelo el descifrado de una transmisión radio alemana de 1918 cifrada con ADFGVX, reconstruida a partir de solo 170 símbolos. Lo relevante para el sector no es el valor histórico del hallazgo, sino el perfil de la tarea: horizonte largo, herramientas propias y resultado fácilmente verificable por terceros.
El caso que documenta 𝕏 @deredleritt3r (Prinz) es el de 1918, con un mensaje sobre un crucero inglés y un escuadrón aliado que, por lo que sabe, nunca se había descifrado antes.
Lo que subraya 𝕏 @rohanpaul_ai (Rohan Paul) es la dificultad real del problema: reconstruir la transposición ADFGVX y reconocer un texto en claro plausible con apenas 170 símbolos de cifrado.
Para 𝕏 @SciTechera (Scitech Era) el interés está en el cambio de fase de los agentes de investigación, más que en el resultado concreto, con las posiciones inciertas del criptograma ampliando el espacio de búsqueda.
La reacción de 𝕏 @DeryaTR_ (Derya Unutmaz, Md) es de entusiasmo sin matices por el hecho de que todo el proceso se resolviera sin intervención humana en diez horas.
La descripción que hace 𝕏 @MTSlive (Mts) se queda en la secuencia operativa (búsqueda en archivos, código de ataque y prueba de claves), que es la parte reproducible del anuncio.
Más información:
📎 The Top 50 unsolved encrypted messages